 /
PLN
High Bandwidth Memory – co to jest i dlaczego AI inżynierowie ją kochają?
HBM, czyli High Bandwidth Memory, to technologia, która w ostatnich latach stała się nieodzownym elementem sprzętu wykorzystywanego w AI, HPC i centrach danych. Nie chodzi tu tylko o kolejną wersję pamięci – chodzi o kompletnie nową architekturę, która pozwala akceleratorom działać szybciej, sprawniej i efektywniej energetycznie. W tym wpisie zobaczysz, dlaczego inżynierowie sztucznej inteligencji kochają HBM, jak wygląda jej rozwój, ile naprawdę kosztuje – i dlaczego, mimo tych kosztów, nikt już nie patrzy w stronę klasycznych DRAM-ów.
HBM to nie tylko nowy typ pamięci – to architektura pod AI, jakiej do tej pory nie było
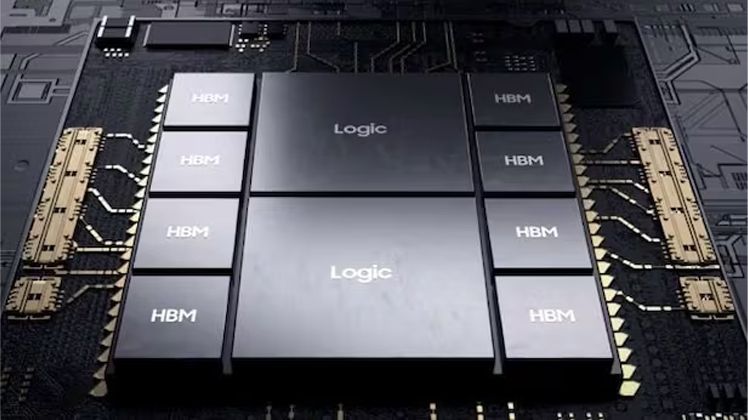
Zacznijmy od podstaw. High Bandwidth Memory (HBM) to technologia DRAM zaprojektowana z myślą o maksymalnej przepustowości i minimalnym zużyciu energii, wykorzystywana głównie w układach graficznych i akceleratorach AI. W odróżnieniu od klasycznych modułów DDR lub GDDR HBM opiera się na wertykalnym ułożeniu chipów DRAM połączonych przy pomocy TSV (Through-Silicon Vias) i zintegrowanych z procesorem przy użyciu interposerów krzemowych. To nie jest tylko nowy typ kości – to zupełnie nowy sposób myślenia o dostępie do pamięci.
W praktyce ta architektura oznacza jedno: znacznie krótsze ścieżki sygnałowe, wyższą gęstość upakowania i niespotykaną szerokość magistrali danych. Jeden stos HBM może mieć magistralę o szerokości aż 1024 bitów, podczas gdy GDDR zwykle operuje na 32 bitach. HBM3E, wprowadzona w 2023 roku, osiąga do 1229 GB/s przepustowości przy 48 GB pojemności na stos, co już dziś pozwala GPU obsługiwać ogromne zbiory danych bez zatykania buforów.
A to dopiero początek – HBM4 (planowane na 2026) ma dojść do 1,6 TB/s przy 64 GB pojemności. W kontekście infrastruktury AI czy HPC to zmiana reguł gry, która umożliwia skalowanie obciążeń bez przenoszenia bottlenecków na poziom RAM.
Dlaczego HBM wygrywa z DDR i GDDR? Przepustowość, opóźnienia i zużycie energii nie zostawiają złudzeń
Tradycyjna pamięć DRAM – niezależnie czy mówimy o DDR5, GDDR6 czy LPDDR – po prostu nie daje rady, jeśli chodzi o przepustowość wymaganą przez współczesne układy AI. HBM nie tylko oferuje znacznie większą szerokość interfejsu, ale też robi to przy niższym napięciu i mniejszym zużyciu energii. W konkretnych liczbach: HBM zużywa od 3,5 do 4,5 razy mniej energii w warstwie PHY niż GDDR6, przy tej samej przepustowości. To oznacza nie tylko oszczędność energetyczną, ale też mniejsze wymagania termiczne i większą efektywność chłodzenia – kluczowe przy pracy w serwerowniach czy centrach danych.
Różnice w przepustowości są równie znaczące. GDDR6 kończy się w okolicach 600 GB/s, natomiast HBM3E pozwala osiągnąć aż 1,2 TB/s. Z kolei latencje dostępu do danych są niższe nie tylko dzięki fizycznej bliskości chipów, ale też dzięki eliminacji części opóźnień wynikających z klasycznego layoutu płyty głównej. W efekcie model AI może nie tylko uczyć się szybciej, ale też szybciej wnioskować – i to bez przestojów wynikających z czekania na dostęp do RAM. Dlatego jeśli Twoja infrastruktura korzysta z intensywnych obciążeń obliczeniowych, przejście na HBM to nie opcja – to warunek stabilnego wzrostu.
AI kocha HBM, bo nie ma wyjścia – tradycyjne DRAM nie nadąża za modelami
Nie chodzi tylko o to, że HBM jest szybsza. Chodzi o to, że modele sztucznej inteligencji nie dają dziś innego wyboru. Kiedy masz do czynienia z setkami miliardów parametrów, dziesiątkami tysięcy tokenów i dziennymi wsadami danych liczonymi w petabajtach – każda mikrosekunda dostępu do pamięci zaczyna być wąskim gardłem. Tradycyjna DRAM – nawet w wersji DDR5 – nie jest w stanie zapewnić takiej przepustowości i gęstości jak HBM. W efekcie maszyna czeka. I to nie na GPU, tylko na RAM.
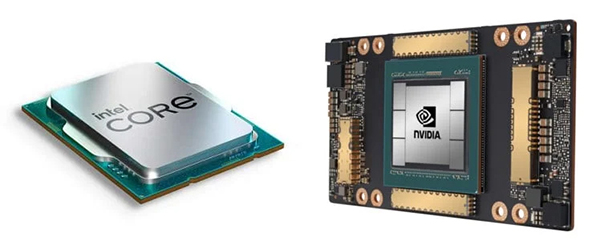
High Bandwidth Memory powstała dokładnie po to, żeby tego problemu nie było. GPU i akceleratory AI, takie jak NVIDIA H100, AMD MI300 czy Intel Gaudi 3, mają tak ogromne zapotrzebowanie na przepustowość, że bez HBM ich potencjał byłby niewykorzystany. Jak powiedział Jim Handy z Objective Analysis – bez HBM musiałbyś mieć kilka procesorów zamiast jednego, co i tak nie dawałoby podobnego efektu. HBM upraszcza architekturę systemu, zmniejsza liczbę komponentów, a jednocześnie skaluje się liniowo wraz z rosnącymi wymaganiami modeli AI. Dzięki temu nie musisz rozbudowywać całej platformy – wystarczy, że używasz lepszego interfejsu pamięci.
Ile kosztuje HBM i dlaczego mimo to jest warte każdych pieniędzy?
Wysoka cena HBM nie jest tajemnicą – i rzeczywiście może zaskoczyć. Jeden gigabajt HBM kosztuje około 10,6 dolara, podczas gdy DRAM to koszt rzędu 2,9 dolara, a DDR5 nawet jeszcze mniej. Ale przy HBM nie płacisz za pojemność. Płacisz za przepustowość, efektywność energetyczną i brak bottlenecków, które w systemach AI przekładają się bezpośrednio na czas trenowania modeli, a więc na koszty operacyjne. Według analiz kosztowych, GPU NVIDIA H100 kosztuje około 3000 USD, z czego połowa ceny to sama pamięć HBM dostarczana przez SK Hynix.
Mimo tej ceny marża operacyjna dla producentów sięga nawet 87% – co oznacza, że klienci korporacyjni są gotowi płacić, bo zyskują przewidywalność i wydajność. To się po prostu spina. Model wytrenujesz szybciej, system zużyje mniej energii, a efektywniejsze zarządzanie obciążeniem pozwoli Ci lepiej wykorzystać zasoby sprzętowe. I nawet jeśli na starcie płacisz więcej, realny ROI (return on investment) w ujęciu rocznym okazuje się bardziej korzystny niż przy tanich systemach z klasycznym DRAM. Szczególnie jeśli budujesz infrastrukturę na lata, a nie na kwartał.
Custom HBM to przyszłość – pełna kontrola nad przepustowością i zużyciem
Standard HBM to już potężne narzędzie, ale coraz więcej firm idzie krok dalej. Custom HBM (cHBM) pozwala projektować pamięć w sposób dopasowany do konkretnych zadań – np. AI inference, grafika 3D czy symulacje kwantowe. Dzięki architekturze 2.5D interposerom krzemowym i własnym kanałom komunikacyjnym, firmy takie jak Marvell tworzą dedykowane układy cHBM, które przekraczają ograniczenia klasycznych interfejsów. W praktyce oznacza to większą gęstość danych, lepszy stosunek mocy do wydajności i lepszą kontrolę nad topologią systemu.
To już nie tylko pamięć – to element projektu całej platformy. Możesz decydować, ile kanałów wykorzystujesz, jak rozkładasz dane i jakie latencje akceptujesz. W świecie, gdzie różnice w wydajności są liczone nie w procentach, ale w czasach trenowania, ta elastyczność daje realną przewagę. Według Samsunga udział custom HBM ma przekroczyć 50% w najbliższych latach, bo coraz więcej firm potrzebuje precyzyjnego dopasowania sprzętu do obciążenia. I wbrew pozorom, to wcale nie jest opcja tylko dla gigantów – wystarczy, że działasz w niszy, gdzie standardowa konfiguracja Cię ogranicza.
Uwaga na dostępność – HBM może zabraknąć szybciej, niż zdążysz zaplanować projekt
Obecnie na rynku funkcjonują tylko trzej dostawcy HBM: SK Hynix, Samsung i Micron, a możliwości produkcyjne są ograniczone przez technologię pakowania 2.5D i wymagające procesy testowania. TSMC ma w tym segmencie dominującą pozycję, ale i oni sygnalizują ograniczenia przepustowości w fabrykach. Już dziś ceny HBM rosną o 5–10% kwartalnie, a raporty z rynku sugerują, że dostępność będzie problemem strategicznym przez najbliższe dwa lata.
Jeśli więc myślisz o wdrożeniu infrastruktury AI w najbliższym czasie – uwzględnij dostępność HBM jako kluczowy parametr planowania. Nie chodzi tylko o to, ile sztuk potrzebujesz, ale kiedy musisz je zakontraktować, z kim negocjować dostawy i jak zarządzać magazynowaniem. Wiele firm już dziś podpisuje wieloletnie umowy z dostawcami, by zabezpieczyć ciągłość łańcucha dostaw. Jeśli w Twoim harmonogramie projektowym pamięć traktowana jest jako ostatni punkt „do wyboru”, ryzykujesz, że nie zdążysz jej kupić, zanim wszystko pójdzie w produkcję. A wtedy nawet najlepszy GPU nie zrobi różnicy.
Serwery do AI – jakie GPU i CPU sprawdzą się w obliczeniach głębokiego uczenia?
Trenowanie dużych modeli AI to nie zabawa dla zwykłych desktopów.
Jak działa inference w AI i jaki serwer zapewni najlepszą wydajność?
Jeśli wdrażasz modele AI w środowisku produkcyjnym, wiesz, że czas odpowiedzi staje się ważniejszy niż sam wynik modelu.
Od klimatyzacji po kontrolę dostępu – kompletne wymagania dla bezpiecznego pomieszczenia serwerowego
Serwerownia to nie tylko miejsce na szafy rackowe i migające diody.
Wirtualizacja serwerów w praktyce – jak zwiększyć elastyczność bez inwestycji w nowy sprzęt?
Masz coraz więcej zadań, ale nie masz jak rozbudować sprzętu?
Administrator systemów – fundament każdej bezpiecznej i dostępnej infrastruktury. Czym zajmuje się w praktyce admin serwera?
Administrator systemów to ten, kto stoi za każdą usługą, serwerem i aplikacją w firmie
SSD czy HDD w serwerowni – co naprawdę się opłaca przy dużych wolumenach danych?
SSD czy HDD

Cluster computing – co to jest, jak działa i dlaczego skaluje się lepiej niż klasyczne serwery?
Masz dość przeciążonych serwerów, które nie nadążają za rozwojem firmy?
Chłodzenie serwerów AI – jak zapanować nad temperaturami przy dużym TDP?
AI to nie tylko modele i dane – to także ciepło.
Dyski hybrydowe w serwerach – realna oszczędność czy niepotrzebna komplikacja?
Dyski hybrydowe w serwerach
Konwencja nazewnictwa serwerów Dell Power Edge
Poznaj podział serwerów Dell Power Edge i ich nazewnictwo.
Jaki serwer wybrać?
Zobacz nasz przewodnik po rodzajach serwerów; ich zaletach i wadach.
Optymalizacja cyberbezpieczeństwa w myśl dyrektywy NIS2
Przeczytaj czy dyrektywa NIS 2 dotyczy Twojej firmy.
Dyski NVMe: jak działają i dlaczego warto je wybrać do serwera?
Dowiedz się jak działa dysk NVMe i jakie są zalety wykorzystania go w nowoczesnych serwerach.
Nowy serwer czy serwer recertyfikowany – jaki wybrać?
Zobacz na czym polega odnowienie serwera i jakie korzyści daje użycie sprzętu recertyfikowanego.
Przewaga posiadania sprzętu IT On-Premise nad rozwiązaniami chmurowymi
Przewaga posiadania sprzętu IT On-Premise nad rozwiązaniami chmurowymi
Nowa podatność regreSSHion w modułach iDRAC w serwerach Dell
Uwaga! Informujemy o ważnej kwestii dotyczącej bezpieczeństwa.
Jak skutecznie przeciwdziałać atakom typu DDoS
Zobacz jak skutecznie przeciwdziałać atakom typu DDoS
RAID – ochrona danych czy zbędny wydatek?
Czy macierze RAID to faktyczna ochrona danych czy zbędny wydatek?

Jak skutecznie zarządzać zasilaniem w serwerowni?
Czy wiesz jak skomplikowanym elementem ekosystemu w Data Center będzie zarządzanie energią i zasilaniem?
Server DNS nie odpowiada? Zobacz, co zrobić, zanim stracisz cierpliwość
Jak radzić sobie z komunikatem "Serwer DNS nie odpowiada".
Protokół SNMP – co musisz o nim wiedzieć, zanim zaczniesz?
Co to jest SNMP i dlaczego warto to wiedzieć przed wdrożeniem?
IOPS – niedoceniany bohater wydajności. Czy Twój dysk go ma?
W tym wpisie sprawdzisz, co realnie oznacza IOPS, jak je mierzyć.
TBW – co oznacza ten parametr i dlaczego wpływa na żywotność SSD?
TBW (Total Bytes Written) to wskaźnik, który mówi, ile danych możesz zapisać na dysku SSD w całym okresie jego życia.
ECC i non-ECC w infrastrukturze IT – kiedy wydajność musi ustąpić niezawodności?
Pamięć RAM ECC czy non-ECC czyli decyzja która może zaważyć na stabilności całej infrastruktury.
Jak rozumieć sieć w kontekście nowoczesnych środowisk serwerowych?
Sieć komputerowa to coś więcej niż kable i routery – to fundament działania każdej infrastruktury IT w firmie.
Procesory Intel w serwerach i stacjach roboczych – jak rozszyfrować oznaczenia i wybrać odpowiednią serię
Wybór procesora do serwera albo stacji roboczej nie kończy się na liczbie rdzeni.
Zdalny dostęp do serwera nawet bez systemu? Poznaj IPMI i jego możliwości
Zdalny dostęp do serwera, nawet gdy system nie wstał? IPMI robi to możliwe – i to bez żadnych sztuczek.
Hardware Direct oficjalnym partnerem Proxmox
Hardware Direct z dumą informuje, że zostaliśmy autoryzowanym partnerem Proxmox Server Solutions
Globalna awaria AWS: techniczne post‑mortem, wzorce branżowe i wnioski dla architektury IT
Poniedziałek, 20 października 2025 roku przejdzie do historii jako dzień, w którym znaczna część internetu po prostu przestała działać.
Proxmox: Dlaczego warto wybrać rozwiązanie open-source przy budowie infrastruktury serwerowej?
Poznaj zalety Proxmox VE jako alternatywy dla VMware: pełne funkcje bez opłat licencyjnych, elastyczne subskrypcje i realne oszczędności w infrastrukturze IT.
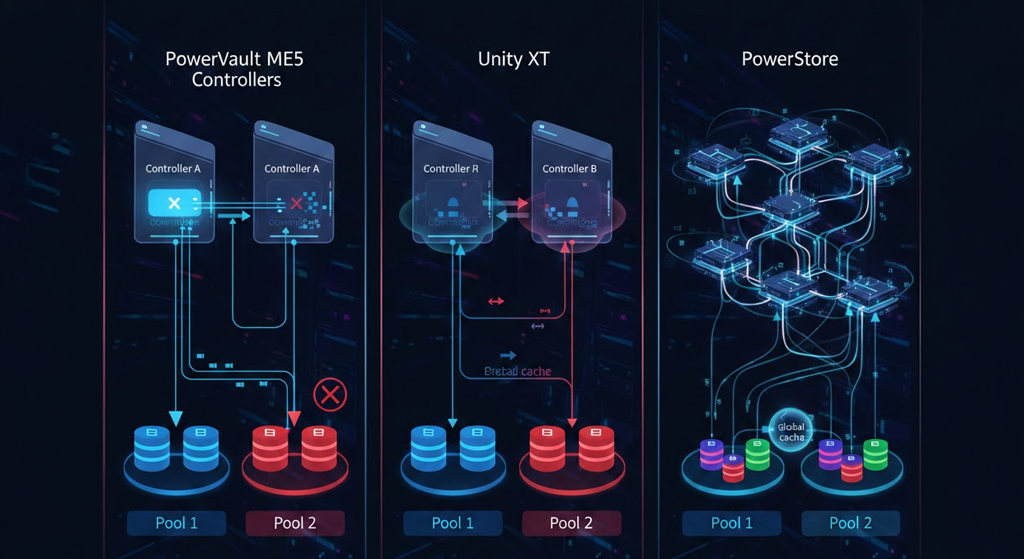
Active-active w macierzach dyskowych – dlaczego tak trudno jednoznacznie wyjaśnić, o co naprawdę chodzi?
Gdy użytkownicy mówią o kontrolerach w macierzach typu active-active, sądzą, że oba kontrolery pracują jednocześnie i obsługują ruch I/O w tym samym czasie. W praktyce bywa inaczej.
Dell PowerStore: 7 Faktów, które zmieniają reguły gry w Twojej infrastrukturze
Współczesne działy IT, które znalazły się w samym sercu operacyjnej pułapki nagłego przyrostu danych w łatwy sposób mogą pozbyć się problemu.
Hardware Direct Gold Partnerem Dell Technologies
Z dumą ogłaszamy uzyskanie statusu Gold Partnera Dell Technologies.
Wąskie gardła dostaw sprzętu enterprise
Planowanie infrastruktury IT wymaga znalezienia równowagi między architekturą, budżetem a harmonogramem wdrożenia.
NVIDIA RTX PRO 6000 Blackwell w serwerze Dell PowerEdge R750 – dlaczego specyfikacja mija się z praktyką? (Nasze testy)
Sprawdź wyniki testów NVIDIA RTX PRO 6000 Blackwell w Dell PowerEdge R750. Dowiedz się, dlaczego 15. generacja serwerów nie radzi sobie z mikroskokami napięcia i dlaczego R760 to lepszy wybór dla AI.
Premiera Proxmox VE 9.2: Analiza kluczowych zmian dla klastrów High Availability
Sprawdź, co premiera Proxmox VE 9.2 oznacza dla środowisk produkcyjnych. Poznaj Dynamic Load Balancer, ulepszone HA i nowe funkcje SDN.
R7425 jako serwer do AI – kiedy AMD EPYC ma przewagę nad Xeonem?
Dell PowerEdge R7425 is one of those servers that looks "just solid" on paper, but when you see it with AI, that's where its real advantage becomes clear.
Recertyfikowany serwer Dell do AI – kiedy warto wybrać go zamiast nowego?
Jeszcze kilka lat temu recertyfikowany serwer kojarzył się głównie z „tańszą używką”. Dziś sytuacja wygląda zupełnie inaczej.
R750xa / R760xa – serwery do treningu modeli LLM w firmie? Jak najbardziej!
Jeszcze rok temu wiele firm zakładało, że lokalne LLM to zabawa wyłącznie dla największych graczy.
C4140 i DSS8440 – czy starsze platformy GPU nadal mają sens w AI, czy to już tylko sprzęt „na przeczekanie”?
C4140 i DSS8440 nie są już „najgorętszymi” platformami GPU na rynku - ale to wcale nie oznacza, że przestały mieć sens.
128 GB, 512 GB czy 2 TB RAM – ile pamięci potrzebuje serwer AI?
Przy serwerach AI bardzo łatwo wpaść w myślenie: „im więcej RAM-u, tym lepiej”.
Czy bardziej opłaca się kupić dwa tańsze serwery GPU niż jeden topowy?
Kupując serwer AI bardzo łatwo dojść do wniosku, że najlepiej od razu postawić na „najmocniejszą możliwą konfigurację”.
Jak skonfigurować serwer do trenowania modeli obrazowych (CV, video)?
Modele obrazowe i video AI potrafią zajechać serwer dużo szybciej niż klasyczne LLM-y tekstowe.
Jaki serwer GPU dla studia VFX i renderingu 3D?
Renderowanie 3D potrafi bardzo szybko pokazać, czy infrastruktura była budowana „pod specyfikację”, czy pod realną pracę studia.
Model hybrydowy: inference lokalnie, training w chmurze – jak to poukładać?
Coraz więcej firm dochodzi dziś do momentu, w którym klasyczne „wrzucamy wszystko do chmury” przestaje być sensowne.
Serwer Rack czy Tower - co wybrać?
Wybór serwera to nie tylko decyzja o tym, co kupić dziś – ale o tym, jak Twoja firma będzie działać przez kolejne lata.
Serwer Rack czy Blade - co wybrać?
Rack czy Blade – to nie jest tylko pytanie o obudowę, ale o sposób działania całej infrastruktury IT.
Dell PowerEdge czy HP ProLiant – odwieczny dylemat administratorów i specjalistów IT. Na co postawić?
Dwa najpopularniejsze systemy serwerowe na rynku. Oba sprawdzone. Oba stabilne. Oba mają swoich zwolenników.
Serwery Rack – czym są i co warto o nich wiedzieć, zanim podejmiesz decyzję zakupową?
Serwery Rack to nie tylko metalowe skrzynki do szafy – to kręgosłup wielu nowoczesnych firm.
Serwery Tower – czym są i dlaczego wielu firmom wciąż bardziej się opłacają niż Rack?
Serwer Tower to nie relikt przeszłości – to wciąż realna, sensowna opcja dla firm, które nie potrzebują całej szafy rackowej, ale chcą poukładanej infrastruktury IT.
Serwer do backupu firmowego – ile TB, jaki RAID i jakie dyski naprawdę mają sens?
Serwer do backupu to nie „tańsza wersja” serwera produkcyjnego.
Konfiguracja serwera do małej firmy 5–20 użytkowników – co wybrać i dlaczego? Sprawdź!
Pierwszy serwer w małej firmie nie musi być skomplikowany – ma po prostu działać stabilnie, cicho i bezpiecznie przez kilka lat.
Konfigurator serwera do wirtualizacji firmowej – jak dobrać moc pod VM-ki?
Wirtualizacja kusi prostotą – „wrzuć VM-ki na host i działa”.
Serwer do bazy danych – jak dobrać wydajną konfigurację?
Baza danych nie wybacza błędów konfiguracyjnych – jeśli sprzęt jest źle dobrany, aplikacja zaczyna „mulić”, użytkownicy czekają na odpowiedzi, a dział IT tłumaczy się z opóźnień.
Jaki serwer do ERP? Jak skonfigurować go bez błędów?
System ERP potrafi działać płynnie latami – pod warunkiem że stoi na dobrze dobranym serwerze, a nie na przypadkowej konfiguracji „bo wystarczy”.
Serwer CTO od ręki – co to właściwie znaczy i czy warto zamiast „gotowca”?
Jeśli stoisz przed wyborem serwera i widzisz „CTO od ręki”, to naturalne pytanie brzmi: czy to faktycznie coś lepszego niż gotowa konfiguracja, czy tylko marketingowa nazwa.
Serwery do AI: lepiej kupić GPU on-premise czy płacić za chmurę
Jeśli robisz AI dłużej niż chwilę, to prędzej czy później trafiasz na ten moment: rachunki za GPU zaczynają wyglądać dziwnie poważnie.
Serwer lokalny czy chmura – co naprawdę bardziej opłaca się w firmie?
Jeśli stoisz przed wyborem: postawić własny serwer czy iść w chmurę, to wcale nie jest decyzja „technologiczna” – tylko biznesowa.
Jaki serwer do pracy z AI – GPU czy stacja robocza? Podpowiadamy
Jeśli dojdziesz do momentu, w którym zastanawiasz się „czy dalej cisnąć na stacji, czy już iść w serwer” – to znaczy, że jesteś dokładnie w tym punkcie, w którym zaczyna się realna infrastruktura AI.
Czym jest serwer recertyfikowany – czym różni się od używanego?
Jeśli stoisz przed wyborem serwera i widzisz w ofertach „recertyfikowany”, „refurbished” albo po prostu „używany” – łatwo się pogubić.
Jak wybrać serwer GPU do AI – żeby nie przepłacić i nie utknąć z za słabą konfiguracją?
Jeśli stoisz przed wyborem serwera pod AI, to problem zwykle nie brzmi „jaki model wybrać”, tylko ile mocy naprawdę potrzebujesz.
Najlepsze serwery on-premise do pracy z AI – ranking 2026. Co ma sens do inference, a co do trenowania modeli?
Jeśli myślisz o AI on-premise, to wybór serwera nie zaczyna się od modelu Dell czy HPE, tylko od tego, co realnie chcesz na nim robić.
Rok 2026 pod znakiem braków GPU – jak planować projekty AI, kiedy serwerów nie ma na magazynie?
Jeśli planujesz projekt AI i liczysz na szybki zakup serwera z GPU – w 2026 możesz się mocno zdziwić.
Dlaczego nowe serwery do AI drożeją z kwartału na kwartał i jak nie przepłacić za infrastrukturę?
Ceny serwerów do AI rosną szybciej, niż większość firm jest w stanie to realnie uchwycić – i to nawet wtedy, gdy mówimy o dokładnie tej samej konfiguracji.
Lead time na data-center GPU sięga roku – jakie masz opcje, gdy nie możesz czekać 12 miesięcy?
Nie masz dostępu do GPU przez najbliższe 12 miesięcy? To nie jest problem technologiczny – tylko decyzja, jak chcesz prowadzić projekt.
Leasing, wynajem czy zakup serwera – którą formą finansować infrastrukturę?
Najwięcej błędów przy zakupie serwera nie wynika z wyboru modelu, tylko z tego, jak ten sprzęt zostaje sfinansowany.
Rosnące ceny pamięci DDR5 i SSD w serwerach – co to oznacza dla budżetu działu IT w 2026?
Koszt pamięci w serwerach w 2026 przestał być detalem – to jeden z głównych składników budżetu.
Jak dobrać liczbę kart GPU w serwerze Dell PowerEdge do modeli AI?
Z liczbą GPU w serwerze jest trochę tak, że łatwo pójść w złą stronę już na starcie.
Dell Precision vs Lenovo ThinkStation – porównanie stacji roboczych, które wybrać?
Wybór między Dell Precision a Lenovo ThinkStation rzadko sprowadza się do „co jest lepsze”.
AI w finansach – jaki serwer do fraud detection i modeli ryzyka?
Fraud detection w AI nie wybacza słabego serwera – tu albo liczysz transakcje w milisekundach, albo liczysz straty.
RAID w serwerze AI – kiedy wystarczy SSD, a kiedy NVMe?
Jeśli zastanawiasz się, czy do serwera AI wrzucić SSD czy NVMe – odpowiedź brzmi: to zależy od tego, co naprawdę robisz na dysku.
Jak policzyć TCO serwera AI – nowy vs recertyfikowany?
Jeśli stoisz przed wyborem serwera AI, to sama cena zakupu niewiele mówi.
Jak wybrać procesor serwerowy – żeby nie przepłacić?
Z procesorem serwerowym jest trochę tak, że najłatwiej pomylić się na samym starcie.
Ranking procesorów serwerowych 2026 – TOP10 procesorów do serwera
Procesor serwerowy dobiera się pod zastosowanie, nie pod sam benchmark – dlatego ten ranking ułożyliśmy według realnych scenariuszy biznesowych (wirtualizacja, ERP, SQL, AI), a nie wyłącznie liczby rdzeni.
Co to jest procesor serwerowy - jak działa i czym różni się od domowego procesora?
Procesor serwerowy to układ zbudowany na tej samej mikroarchitekturze co jego domowy odpowiednik, ale wyposażony w cechy klasy enterprise.
Intel Xeon czy AMD EPYC – jaki procesor serwerowy wybrać do swojej infrastruktury?
Z wyborem procesora serwerowego jest trochę tak, że łatwo pójść w złą stronę już na starcie.
TDP procesora – co to jest i czy musisz się tym przejmować przy wyborze serwera?
Jeśli dobierasz procesor do serwera i utknąłeś przy skrócie TDP, to pytanie jest właściwie jedno: czy ta liczba w watach – 50 W, 85 W, 130 W, czasem 280 W – mówi Ci, ile sprzęt będzie brał prądu?
Macierz dyskowa czy kilka dysków w serwerze? Kiedy i dlaczego warto?
Pytanie, które słyszymy od firm regularnie, brzmi: „Po co mi osobna macierz, skoro mogę wsadzić więcej dysków do serwera?”
Jak wybrać macierz dyskową - na co zwrócić uwagę?
Wyobraź sobie dwie firmy. Pierwsza kupiła macierz „z zapasem”, na styk z budżetem premium – i trzy lata później połowa półek świeci pustkami.
Dysk SSD vs HDD – jaki wybrać do macierzy dyskowej w serwerze?
Gdy klient pyta nas o dyski do macierzy, w dziewięciu przypadkach na dziesięć słyszymy to samo zdanie: „No SSD, bo szybsze”.
Krytyczna luka Januscape (CVE-2026-53359) w KVM
Analiza techniczna luki Januscape ujawnia błąd typu use-after-free w mechanizmie KVM/x86 shadow MMU.
Poziomy RAID – który system wybrać do serwera i dlaczego to nie jest wybór raz na zawsze
Trzy litery, a tyle nieporozumień. RAID towarzyszy serwerom od końca lat 80., kiedy grupa badaczy zauważyła, że zamiast jednego drogiego dysku lepiej spiąć kilka tańszych i sprytnie rozłożyć na nie dane.
SAN vs NAS vs DAS – czym się różnią i którą architekturę storage wybrać dla swojej firmy?
Trzy skróty, które wracają w każdej rozmowie o pamięci masowej – i trzy zupełnie różne filozofie podłączenia dysków do firmowych systemów.
Co to jest serwer firmowy – jak działa i czym różni się od webhostingu?
Serwer firmowy to dedykowany komputer, którego jedynym zadaniem jest obsługiwać inne urządzenia w Twojej firmie – udostępniać pliki, trzymać bazę danych, uruchamiać ERP, obsługiwać pocztę, robić kopie zapasowe.
Czy recertyfikowany serwer GPU jest bezpieczny dla krytycznych danych?
Recertyfikowany serwer GPU potrafi kosztować kilkadziesiąt procent mniej niż nowa konfiguracja enterprise.
Rodzaje serwerów firmowych – który wybrać do swojej firmy?
„Jaki rodzaj serwera wybrać?” to tak naprawdę trzy różne pytania zadane naraz – i większość nieporozumień bierze się z ich mieszania.
Jaki serwer wybrać do monitoringu wizyjnego (CCTV/NVR) – jak dobrać sprzęt do liczby kamer?
A surveillance server is sized around three numbers: camera count, stream bitrate, and recording retention period.
Kontroler macierzy dyskowej – co to jest i jak działa?
A disk array controller is a chip that manages a group of drives as a single, coherent, fault-tolerant unit – it distributes data across drives, calculates parity, rebuilds the array after a drive failure, and speeds up writes using its own cache memory.
NVMe-oF – czym jest i jakie ma zastosowanie?
You've got fast NVMe drives in your servers, but each one is tied to a single machine – and when one is running out of space while another has plenty to spare, you can't move it across.
Dell Compellent SC czy PowerStore – którą macierz wybrać?
Compellent SC is a proven, hybrid block array for classic storage workloads on a reasonable budget, while PowerStore is an enterprise-class native NVMe platform for virtualization, databases, and low-latency-sensitive environments.
Nowa czy recertyfikowana macierz dyskowa – co wybrać dla firmy?
"Recertified" sounds like "used," and "used" sounds like "risk." Except that association doesn't match the numbers – even brand-new enterprise drives fail more often than their spec sheets promise, and recertification is a formalized process, not "dusting off old hardware."
Stacja robocza czy laptop mobilny – co wybrać dla zespołu projektowego?
A desktop workstation wins everywhere raw power matters – 3D CAD, simulations, rendering, AI – while a mobile laptop makes sense when a designer needs to work in the field, at a client site, or across multiple locations.
Jak wybrać stację roboczą dla firmy – przewodnik krok po kroku
Choosing a workstation doesn't start with "which processor," but with "what exactly is it for" – it's the workload type, not the budget, that determines a sensible specification.
Ile serwerów potrzebuje firma – jeden mocny czy kilka mniejszych?
Liczba serwerów zależy od trzech rzeczy: dopuszczalnego czasu przestoju, charakteru obciążenia i wymogów prawnych.
Pierwszy serwer w firmie – czego unikać przy pierwszym wdrożeniu?
Trzy błędy kosztują najwięcej: brak przetestowanej kopii zapasowej, zdalny dostęp wystawiony do internetu bez MFA i pominięcie licencji w budżecie.
Lenovo ThinkSystem czy Dell PowerEdge – co wybrać jako serwer firmowy? Porównanie dla działu IT
Zła wiadomość dla szukających prostej odpowiedzi: pod maską te serwery są niemal bliźniacze – ten sam Intel Xeon albo AMD EPYC, ta sama pamięć DDR5, te same dyski NVMe.
Serwer NAS czy serwer firmowy – czym się różnią i kiedy jaki wybrać?
Sprzedawcy lubią mówić o NAS-ie „serwer plików”, więc łatwo pomyśleć, że to po prostu tańszy serwer.
Ile RAM w serwerze firmowym – jak nie przepłacić i nie zabraknąć pamięci
Jeszcze dwa lata temu odpowiedź brzmiała: weź z zapasem, pamięć jest tania. W 2026 r. ta rada kosztuje majątek – moduł 64 GB DDR5 RDIMM podrożał z około 255 do ponad 870 dolarów w pół roku, a prognozy mówią o 1 586 dolarach na koniec roku.
Dell Compellent SC czy Dell PowerStore – jaką platformę macierzy wybrać? Jakie są różnice?
To porównanie ma dziś jeden dominujący kontekst, o którym trzeba powiedzieć od razu: wsparcie Dell dla modeli SC5020 i SC5020F kończy się 31 sierpnia 2026 roku. Jeśli masz którąś z tych macierzy, pytanie nie brzmi już „czy warto migrować”, tylko „na co i kiedy”.